

9.8: Conclusión, Bibliografía
- Page ID
- 54597

\( \newcommand{\vecs}[1]{\overset { \scriptstyle \rightharpoonup} {\mathbf{#1}} } \)
\( \newcommand{\vecd}[1]{\overset{-\!-\!\rightharpoonup}{\vphantom{a}\smash {#1}}} \)
\( \newcommand{\dsum}{\displaystyle\sum\limits} \)
\( \newcommand{\dint}{\displaystyle\int\limits} \)
\( \newcommand{\dlim}{\displaystyle\lim\limits} \)
\( \newcommand{\id}{\mathrm{id}}\) \( \newcommand{\Span}{\mathrm{span}}\)
( \newcommand{\kernel}{\mathrm{null}\,}\) \( \newcommand{\range}{\mathrm{range}\,}\)
\( \newcommand{\RealPart}{\mathrm{Re}}\) \( \newcommand{\ImaginaryPart}{\mathrm{Im}}\)
\( \newcommand{\Argument}{\mathrm{Arg}}\) \( \newcommand{\norm}[1]{\| #1 \|}\)
\( \newcommand{\inner}[2]{\langle #1, #2 \rangle}\)
\( \newcommand{\Span}{\mathrm{span}}\)
\( \newcommand{\id}{\mathrm{id}}\)
\( \newcommand{\Span}{\mathrm{span}}\)
\( \newcommand{\kernel}{\mathrm{null}\,}\)
\( \newcommand{\range}{\mathrm{range}\,}\)
\( \newcommand{\RealPart}{\mathrm{Re}}\)
\( \newcommand{\ImaginaryPart}{\mathrm{Im}}\)
\( \newcommand{\Argument}{\mathrm{Arg}}\)
\( \newcommand{\norm}[1]{\| #1 \|}\)
\( \newcommand{\inner}[2]{\langle #1, #2 \rangle}\)
\( \newcommand{\Span}{\mathrm{span}}\) \( \newcommand{\AA}{\unicode[.8,0]{x212B}}\)
\( \newcommand{\vectorA}[1]{\vec{#1}} % arrow\)
\( \newcommand{\vectorAt}[1]{\vec{\text{#1}}} % arrow\)
\( \newcommand{\vectorB}[1]{\overset { \scriptstyle \rightharpoonup} {\mathbf{#1}} } \)
\( \newcommand{\vectorC}[1]{\textbf{#1}} \)
\( \newcommand{\vectorD}[1]{\overrightarrow{#1}} \)
\( \newcommand{\vectorDt}[1]{\overrightarrow{\text{#1}}} \)
\( \newcommand{\vectE}[1]{\overset{-\!-\!\rightharpoonup}{\vphantom{a}\smash{\mathbf {#1}}}} \)
\( \newcommand{\vecs}[1]{\overset { \scriptstyle \rightharpoonup} {\mathbf{#1}} } \)
\(\newcommand{\longvect}{\overrightarrow}\)
\( \newcommand{\vecd}[1]{\overset{-\!-\!\rightharpoonup}{\vphantom{a}\smash {#1}}} \)
\(\newcommand{\ket}[1]{\left| #1 \right>}\)
\(\newcommand{\bra}[1]{\left< #1 \right|}\)
\(\newcommand{\braket}[2]{\left< #1 \vphantom{#2} \right| \left. #2 \vphantom{#1} \right>}\)
\(\newcommand{\braopket}[3]{\left< #1 \vphantom{#2}\vphantom{#3} \right| #2 \vphantom{#1}\vphantom{#3} \left| #3 \vphantom{#1}\vphantom{#2} \right>}\)
\(\newcommand{\qmvec}[1]{\mathbf{\vec{#1}}}\)
\(\newcommand{\op}[1]{\hat{\mathbf{#1}}}\)
\(\newcommand{\expect}[1]{\langle #1 \rangle}\)
\(\newcommand{\dfn}[1]{\emph{\textbf{#1}}}\)
La identificación computacional de genes, ya que implica encontrar los elementos funcionales codificados dentro de un genoma, tiene mucho significado práctico y teórico para el avance de los campos bio- lógicos.
Los dos enfoques descritos anteriormente se resumen a continuación en la Figura 9.11:
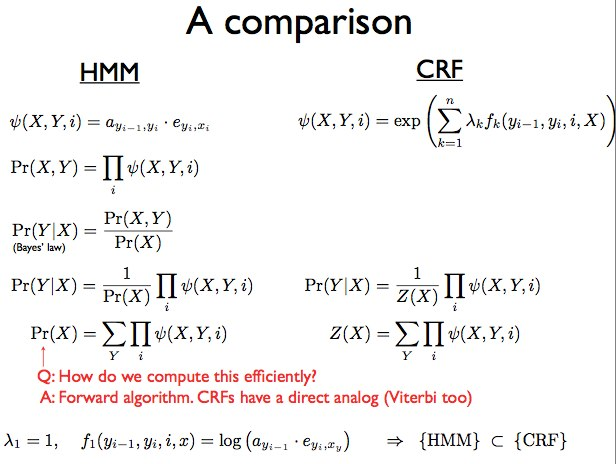
HMM
• modelo generativo
• genera aleatoriamente datos observables, generalmente con un estado oculto
• especifica una distribución de probabilidad conjunta
• P (x, y) = P (x|y) P (y)
• a veces difíciles de modelar dependencias correctamente
• los estados ocultos son las etiquetas para cada base de ADN/letra
• emisiones compuestas son una combinación de la base/letra de ADN que se emite con evidencia adicional
CRF
• modelo discriminativo
• modelos dependencia de la variable no observada y de una variable observada x • P (y|x)
• difícil de entrenar sin supervisión
• más efectivo para cuando el modelo no requiere distribución conjunta
En la práctica, la especificación génica resultante usando CONTRASTE, una implementación de CRF, es de aproximadamente 46.2% en su máximo. Esto se debe a que en biología, hay muchas excepciones al modelo estándar, como genes superpuestos, genes anidados y empalme alternativo. Tener modelos que incluyan todas esas excepciones a veces produce peores predicciones; esta es una compensación no trivial. No obstante, la tecnología está mejorando y dentro de los próximos cinco años, habrá más datos experimentales para impulsar el desarrollo de la identificación computacional de genes, lo que a su vez ayudará a generar una mejor comprensión de la sintaxis del ADN.